Arquitetura
Visão geral
flowchart TD
    Nav[Navegador / Sistemas] --> APP["FastAPI + uvicorn"]

    subgraph proc["Um único processo"]
        APP -->|"GET /"| UI[Produto — UI HTML/JS<br/>templates Jinja2]
        APP -->|"/api/*"| API[API JSON<br/>predict · chat · health · metrics]
    end

    UI -. "fetch /api/*" .-> API
    API --> AG

    subgraph agente["Agente (agent/agent.py)"]
        AG[1. Guardrails de ENTRADA] --> TOOL[2. predict_churn tool]
        TOOL --> LLM[3. Raciocínio LLM OpenAI]
        LLM --> OUT[4. Guardrails de SAÍDA]
        OUT -->|saída coerente| RESP
        LLM -.->|indisponível / erro| FB[5. Fallback determinístico]
        OUT -.->|saída incoerente| FB
    end

    TOOL -.->|SHAP fatores| ML["Pipeline sklearn .pkl — Gradient Boosting"]

    FB --> RESP[Resposta: probabilidade + explicação + ação de retenção]
    RESP --> MON["Monitoring JSONL: latência · custo · fallback · guardrails"]
Um processo, um link
Um único processo (uvicorn) serve toda a aplicação:
/→ produto (UI em HTML, templates Jinja2 + JavaScript que consome a API)/api/*→ API JSON (/api/predict,/api/chat,/api/health,/api/metrics,/api/docs)
Assim produto e API ficam no mesmo endereço. A UI é servida pelo próprio FastAPI e chama os
endpoints /api/* via fetch; os gráficos (medidor de churn e fatores SHAP) são SVG inline.
Menos peças, um único processo, deploy mais simples e confiável.
Componentes
| Camada | Pasta | Responsabilidade |
|---|---|---|
| Modelo | ml/ |
pré-processamento, treino, predição e explicação (SHAP) |
| Agente | agent/ |
orquestração, prompts, ferramentas, guardrails, fallback |
| API + Produto | api/ |
FastAPI: API JSON (/api/*) e a UI (GET /) |
| UI (templates) | product/ |
template Jinja2 (templates/index.html) + metadados do formulário |
| Monitoramento | monitoring/ |
traces JSONL e agregação de métricas |
Exploração de abordagens (agent/model)
O que consideramos antes de decidir:
- Tipo de agente: (a) um classificador "puro" exposto via API vs. (b) um agente com raciocínio. Escolhemos (b), com function calling: o modelo ML entrega o número e os fatores; o LLM traduz em explicação e ação. É a diferença "modelo → agente" pedida no enunciado.
- Ferramentas: uma ferramenta única e forte (
predict_churn= modelo + SHAP) em vez de várias fracas (uma para probabilidade, outra para explicação, outra para ofertas) — menos latência e menos superfície de erro. A ideia das múltiplas tools foi descartada. - Modelo base do agente:
gpt-4o-mini— barato, baixa latência e suficiente para raciocínio estruturado sobre poucos fatores. Modelos maiores não se justificavam pelo custo/latência neste escopo. - Modelo preditivo: comparamos Regressão Logística (baseline) e Gradient Boosting (escolhido) — ver Avaliação.
A visão abaixo reúne essas escolhas e mostra como o modelo preditivo, a ferramenta, o LLM e os mecanismos de confiabilidade se conectam no sistema:
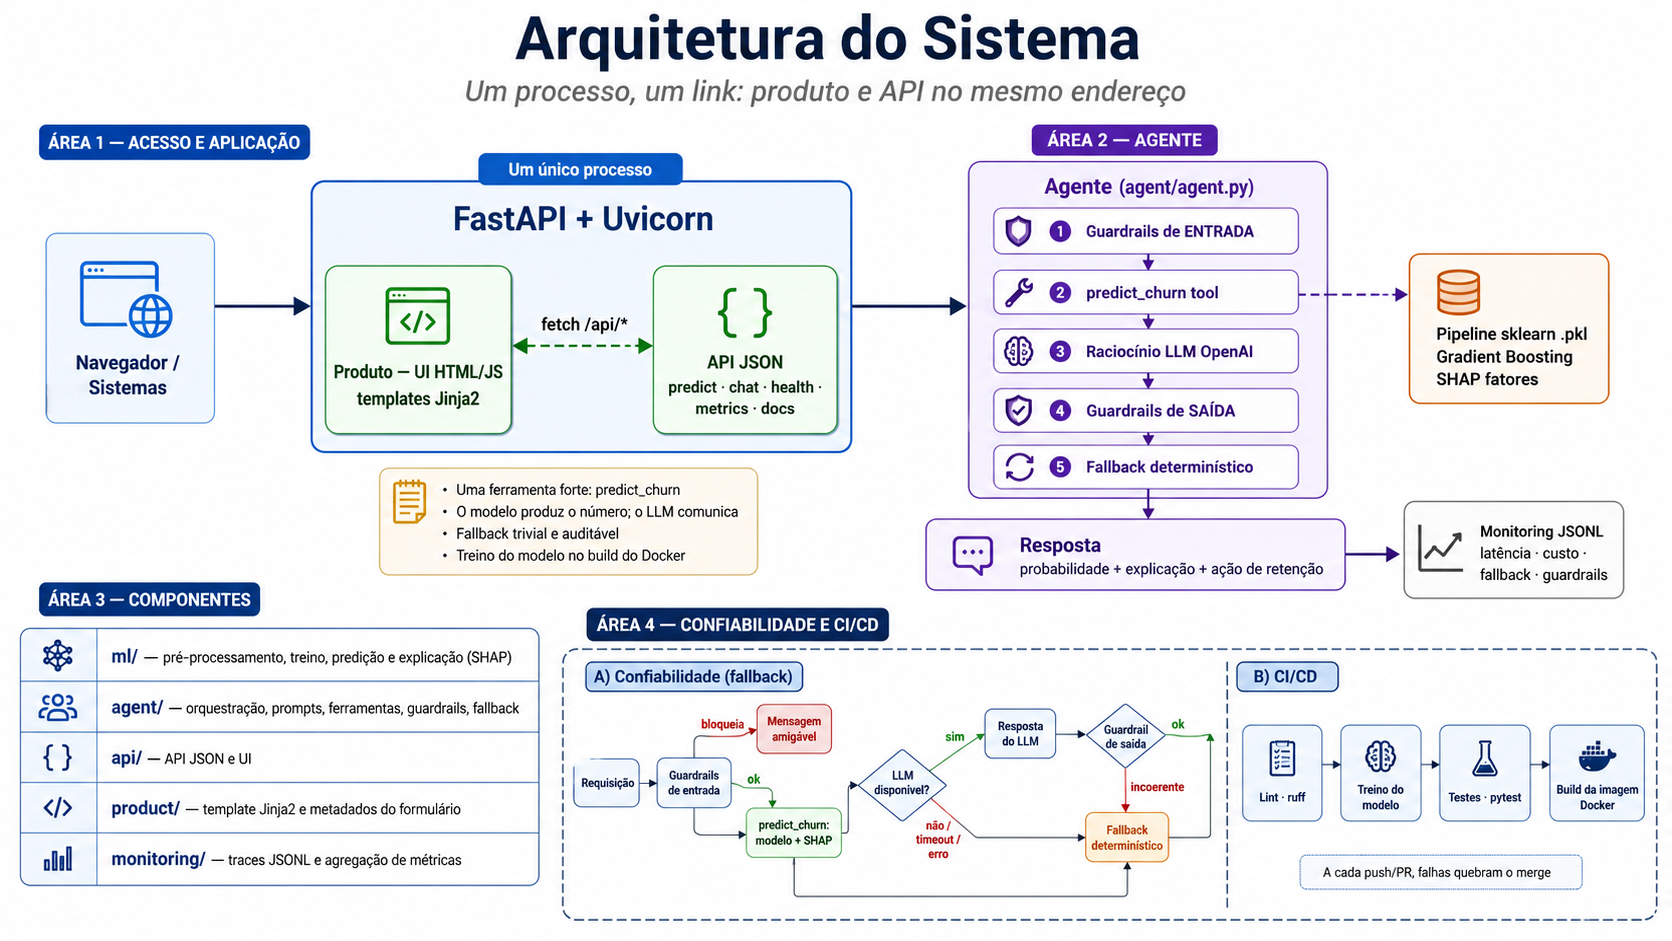
Resumo visual da arquitetura e das principais decisões do projeto.
Decisões de projeto
- Uma ferramenta forte (
predict_churn) em vez de várias fracas → menos latência e menos erro. - Separação de responsabilidades: o número vem do modelo (determinístico, auditável); o LLM só comunica. Isso torna o fallback trivial e a explicação à prova de alucinação.
- Treino no build: o
Dockerfilerodapython -m ml.train, então clone → build → sobe, sem passo manual.
Deployment
- Empacotamento: um único
Dockerfile(multi-stage) instala tudo, treina o modelo no build e roda um único processo —uvicorn api.main:app. Reprodutível: clone →docker compose up→ no ar. - Exposição: o próprio FastAPI serve
/(UI) e/api/*(API) no mesmo endereço público. - Entradas em produção: a API recebe perfis de clientes (mesmo esquema do dataset) via
POST /api/predictouPOST /api/chat; a UI monta esse JSON a partir do formulário e chama viafetch. - Passo a passo em Como rodar e Deploy na VPS.
CI/CD
GitHub Actions (.github/workflows/ci.yml),
a cada push/PR:
flowchart LR
    PUSH[Push / pull request] --> TEST
    PUSH --> DOCS

    subgraph TEST[Qualidade do código]
        L[Lint · ruff] --> T[Treino do modelo] --> P[21 testes · pytest]
    end

    P --> D[Build da imagem Docker]
    DOCS[Build MkDocs strict] --> OK[Documentação válida]
Os jobs de código e documentação podem rodar em paralelo; a imagem Docker só é construída depois que
lint, treino e testes passam. Qualquer etapa que falhar quebra o merge. A documentação tem um workflow próprio
(docs.yml) que
publica este site no GitHub Pages a cada push na main.
Confiabilidade (fallback)
flowchart TD
    A[Requisição] --> B{Guardrails de entrada}
    B -- bloqueia --> M[Mensagem amigável]
    B -- ok --> C[predict_churn: modelo + SHAP]
    C --> D{LLM disponível?}
    D -- não / timeout / erro --> F[Fallback determinístico]
    D -- sim --> E[Resposta do LLM]
    E --> G{Guardrail de saída}
    G -- incoerente --> F
    G -- ok --> H[Resposta final]
    F --> H